Chaque jour, les appareils connectés, les services en ligne et les activités humaines produisent des données. Comment exploiter ces immenses quantités d’informations ? C’est tout l’enjeu du Big Data !
Qu’est-ce que le Big Data ?
Le Big Data, ou données massives, désigne des ensembles de données dont la quantité, la diversité et la vitesse de production nécessitent des outils informatiques adaptés pour les stocker et les analyser.
Ces données peuvent prendre différentes formes : textes, images, vidéos, positions géographiques ou mesures de capteurs.
Le défi consiste à transformer toutes ces données en informations utiles.
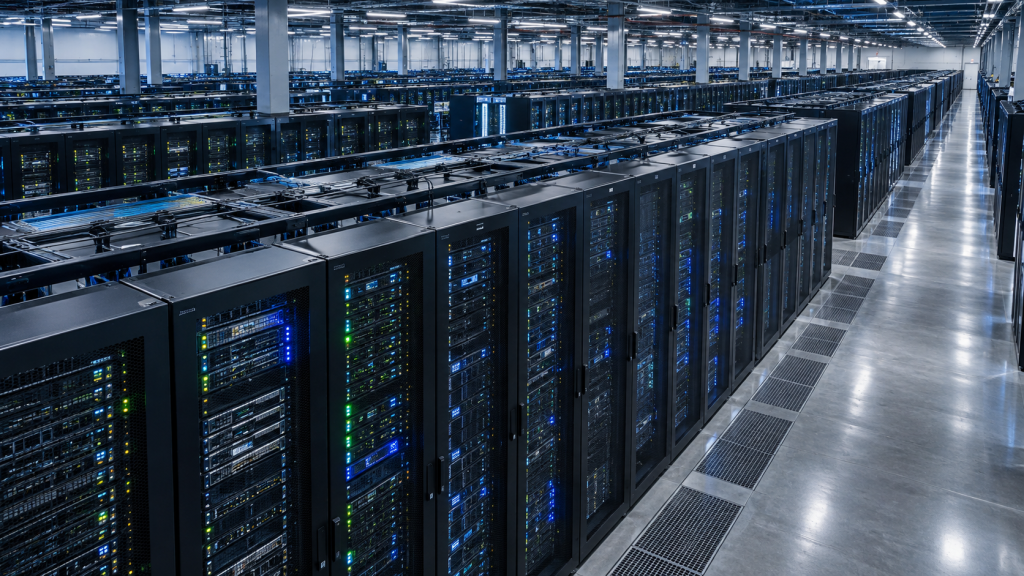
Pourquoi parle-t-on de données massives ?
On décrit souvent le Big Data à l’aide de trois caractéristiques, les « 3 V » :
| Caractéristique | Signification | Exemple |
|---|---|---|
| Volume | Une très grande quantité de données. | Les vidéos hébergées par une plateforme. |
| Vélocité | Des données produites et transmises rapidement, parfois en continu. | Les positions envoyées par de nombreux véhicules. |
| Variété | Des données de différentes natures. | Des textes, des photos et des mesures de température. |
Un simple tableau de quelques températures ne constitue donc pas du Big Data. En revanche, les mesures accumulées par un immense réseau de capteurs peuvent contribuer à un système de données massives.
D’où viennent les données ?
Les données proviennent notamment :
- des services en ligne : recherches, achats, vidéos regardées ou interactions ;
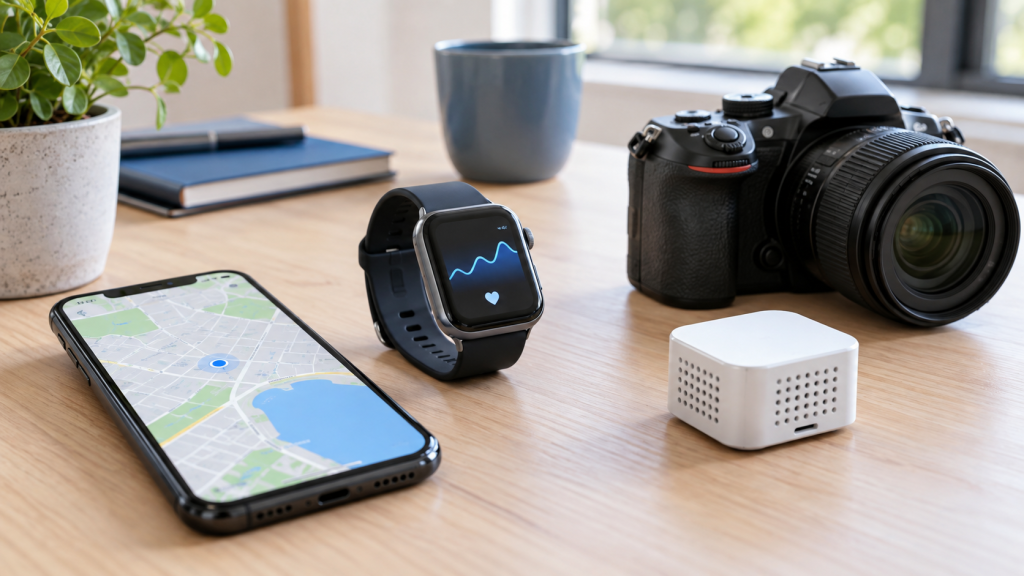
- des objets connectés : montres, compteurs, véhicules ou stations météo ;
- des entreprises et des services publics : transports, production ou consommation d’énergie ;
- de la recherche scientifique : observations, expériences et images satellites.
Par ailleurs, certaines données sont produites volontairement, comme une photographie publiée. D’autres sont enregistrées automatiquement, comme la mesure d’un capteur.
Comment sont-elles exploitées ?
Pour exploiter ces données, un système informatique réalise plusieurs opérations :
- Collecter les données auprès des appareils ou des services.
- Transmettre les données par les réseaux.
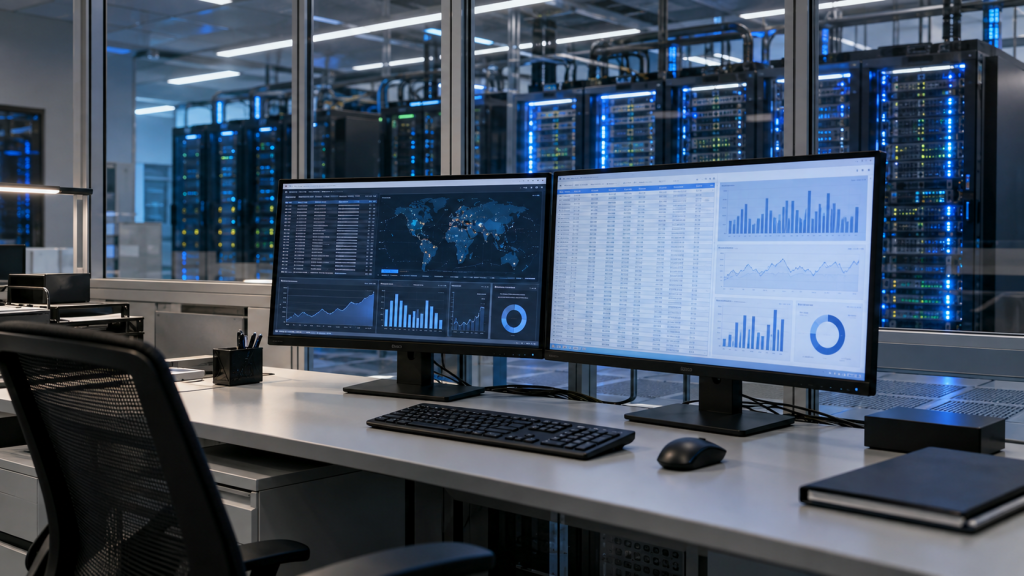
- Stocker et organiser les données sur des serveurs.
- Préparer les données : corriger des erreurs, supprimer les doublons et harmoniser les formats.
- Analyser les données pour repérer des tendances et aider à prendre une décision.
Pour de grands volumes, plusieurs ordinateurs peuvent se partager le stockage et les calculs. Ces équipements peuvent être hébergés dans des centres de données, aussi appelés data centers.
À quoi sert le Big Data ?
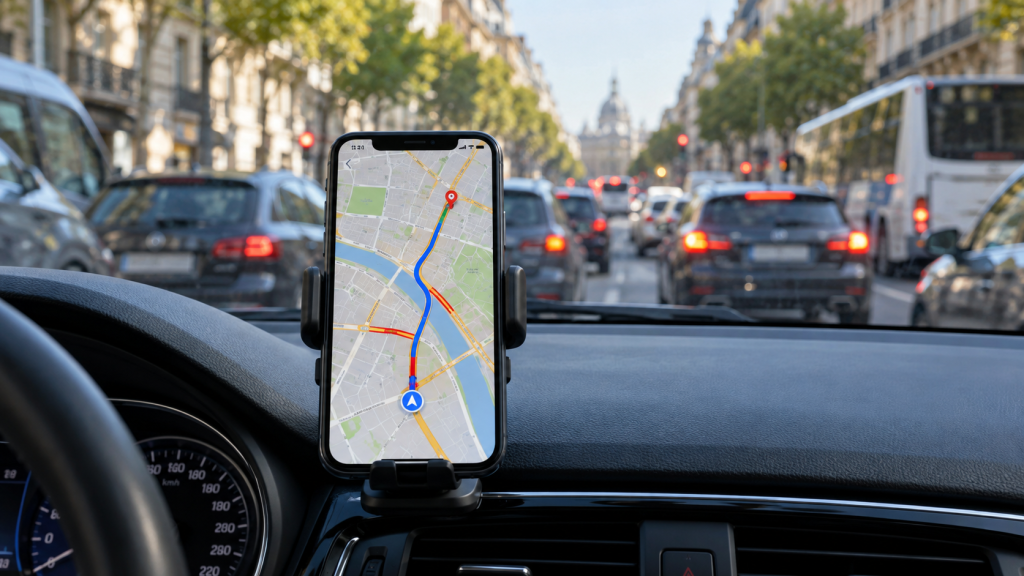
Prenons l’exemple d’un service d’information sur la circulation.
De nombreux appareils transmettent des données de position et de vitesse. Leur analyse permet de repérer les ralentissements et d’estimer les temps de trajet. L’application peut alors proposer un autre itinéraire.
Les données massives servent aussi à :
- adapter la production d’énergie à la consommation ;
- détecter des signes de panne dans des machines ;
- proposer des contenus selon les habitudes des utilisateurs ;
- aider les chercheurs à étudier des phénomènes complexes.
Quel est le lien avec l’intelligence artificielle ?
Le Big Data et l’intelligence artificielle sont déjà associés dans de nombreux systèmes.
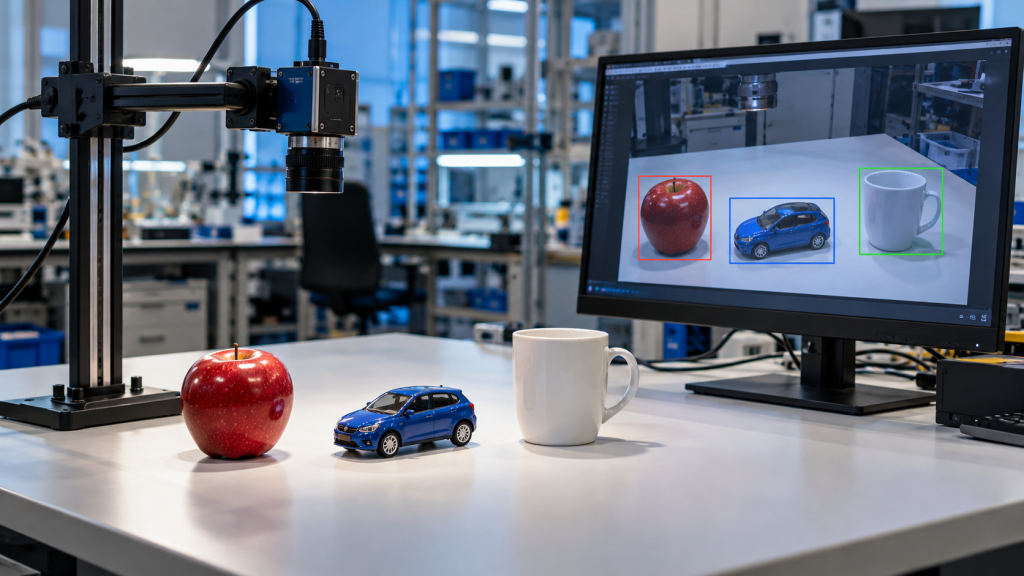
De grandes quantités de données peuvent servir à entraîner des modèles d’IA. Ces modèles apprennent à repérer des régularités pour, par exemple, reconnaître des images ou réaliser des prévisions.
Mais plus de données ne signifie pas automatiquement de meilleurs résultats. Des données erronées (fausses), incomplètes ou peu représentatives peuvent conduire à des erreurs.
Et puis, le Big Data peut aussi être analysé sans IA, et certains modèles d’IA fonctionnent avec de petits ensembles de données.
Quels sont les points de vigilance ?
La vie privée. Certaines données permettent d’identifier une personne, directement ou par recoupement. Retirer son nom ne suffit donc pas toujours à la rendre anonyme.
La fiabilité et la sécurité. Il faut vérifier la qualité des données et protéger leur accès. Ainsi, une analyse fondée sur des données fausses ou modifiées peut conduire à de mauvaises décisions.
L’environnement. Stocker, transmettre et traiter des données mobilise des équipements et de l’électricité. Les centres de données doivent aussi être refroidis. Collecter uniquement les données utiles et éviter les traitements inutiles contribue à limiter ces besoins.
Je retiens :
- Le Big Data concerne des données caractérisées par leur volume, leur vélocité et leur variété.
- Les réseaux transportent les données ; les serveurs les stockent et les traitent.
- Leur analyse permet de repérer des tendances et d’aider à prendre des décisions.
- L’intelligence artificielle peut participer à cette analyse.
- Enfin, on doit aussi prendre en compte la qualité des données, la vie privée, la sécurité et l’environnement.